RTX PRO 5500:84GB显存换来的不是更高带宽,而是AI推理的“装得下”
RTX PRO 5500与RTX 5090采用相同级别的GB202核心,却将显存提升至84GB,同时带宽降至1398GB/s。它的取舍,指向大模型推理、长上下文和专业工作站部署。

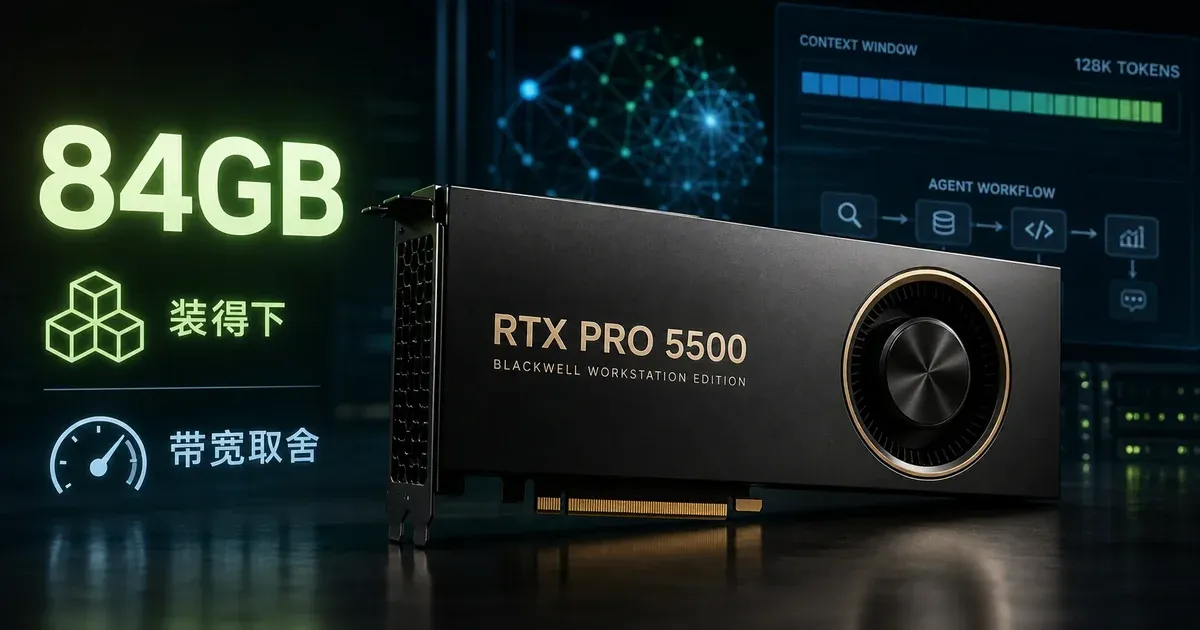
显存多了 2.625 倍,带宽反而少了约 22%。
这是 RTX PRO 5500 最值得分析的地方。英伟达在 2026 年 9 月 14 日上线了 RTX PRO 5500 Blackwell Workstation Edition 的产品页面。这张卡使用 Blackwell 架构和 GB202 芯片,配备 84GB GDDR7 显存,支持 ECC 纠错,显存带宽为 1,398GB/s,整卡功耗上限达到 600W。
如果只看数字,它和 GeForce RTX 5090 的关系很奇怪:两者都被指向同一款 GB202 芯片,PNY 的暂定规格以及媒体转述都给出了 21,760 个 CUDA 核心,但 RTX 5090 只有 32GB 显存,而 RTX PRO 5500 做到了 84GB。与此同时,RTX PRO 5500 的带宽明显低于 RTX 5090,以及更高一级的 RTX PRO 6000。
这不是一张单纯追求最高跑分的显卡。它解决的问题更具体:当模型、上下文、缓存和多个任务必须同时放进显存时,普通高带宽显卡可能根本装不下。
三张 GB202 显卡,三种产品取舍
RTX PRO 5500 的定位,放进 Blackwell 产品线里看会更清楚。
| 产品 | CUDA 核心 | 显存 | 显存特性 | 显存带宽 | 主要定位 |
|---|---|---|---|---|---|
| GeForce RTX 5090 | 21,760,来源状态需限定 | 32GB GDDR7 | 非 ECC | 1,792GB/s,按同代颗粒速率推算 | 消费级、高带宽 |
| RTX PRO 5500 | 21,760,PNY 暂定规格 | 84GB GDDR7 | 支持 ECC | 1,398GB/s | 大显存工作站、AI 推理 |
| RTX PRO 6000 | 24,064 | 96GB GDDR7 | ECC,支持 MIG | 1,792GB/s | 旗舰级专业工作站 |
这里有两个数字不能直接当成英伟达官方最终规格。
第一,英伟达官方页面没有列出 RTX PRO 5500 的 CUDA 核心数,21,760 个核心来自 PNY 的暂定规格。第二,RTX PRO 5500 的位宽也存在分歧:PNY 规格表写的是 416-bit,HotHardware 认为 448-bit 更可能,而英伟达官方页面没有列出这一项。因此,“RTX PRO 5500 与 RTX 5090 核心数相同”可以作为现有规格信息支持下的比较,但不宜写成英伟达已经正式确认的结论。
即便把这些限定保留下来,产品层级仍然很明确。
RTX PRO 5000 的规格为 14,084 个 CUDA 核心,显存最高 72GB。RTX PRO 5500 把核心规模提高到接近 RTX PRO 6000 的水平:如果按 21,760 个核心计算,它只比 RTX PRO 6000 的 24,064 个少约 10%。但在显存容量上,它又非常接近后者的 96GB,比 RTX 5090 多出 52GB,容量是后者的 2.625 倍。
因此,RTX PRO 5500 并不是为了填补一个简单的性能空档。它建立的是一个中间层级:计算能力接近专业旗舰,显存容量接近专业旗舰,但带宽和其他规格没有完全拉到 RTX PRO 6000 的水平。
这张卡的目标用户,大概是需要大显存运行推理,却不需要 RTX PRO 6000 全部计算能力的工作站和企业用户。
为什么要做一张 84GB 的专业卡
显存容量是 RTX PRO 5500 与 RTX 5090 之间最直接的差异,但产品线上的价格空档也很重要。
现有信息显示,RTX PRO 6000 的官方售价为 16,000 美元。RTX PRO 5000 的 72GB 版本价格超过 9,200 美元,二者相差接近 7,000 美元。RTX PRO 5500 的官方售价尚未确认。
这个区间里存在一批需求相当明确的用户:他们希望在本地或工作站环境中运行更大的模型,显存需求高于消费级显卡,但不一定需要 RTX PRO 6000 的最高核心数、最高带宽和完整旗舰规格。
RTX 6000D 也提供了一个参照。它同样配备 84GB 显存,但面向中国市场,并受到出口管制影响。基于这一点,有观点把 RTX PRO 5500 理解为全球市场上的 84GB 专业卡选项。这个判断能够解释产品线为什么出现一个 84GB 型号,但不能进一步写成英伟达已经公开确认 RTX PRO 5500 是 RTX 6000D 的替代品。
对企业用户来说,产品线并不只是“核心越多越快”。如果 96GB 的旗舰卡价格和部署成本太高,72GB 型号又无法覆盖目标模型,84GB 就可能成为一个更容易采购的容量档位。显存在这里不是配件,是一道按 GB 收费的闸门。
84GB 和 1,398GB/s,解决的是两个不同问题
RTX PRO 5500 的低带宽,首先来自它的显存配置取舍。
它的带宽为 1,398GB/s,比 RTX PRO 6000 的 1,792GB/s 低约 22%。RTX 5090 的 1,792GB/s 则是依据同代显存颗粒速率推算出的数值,英伟达官方页面没有列出该带宽,因此也不能把它当成已经完整核实的官方页面参数。
用一个简化计算,可以看出带宽差异意味着什么。
如果把整块显存连续读完:
| 条件 | 理论读取时间 |
|---|---|
| 84GB,1,398GB/s | 约 60.1 毫秒 |
| 32GB,1,792GB/s | 约 17.9 毫秒 |
两者相差约 3.36 倍。但这只是把显存视为连续数据块的理论计算,不是模型推理基准,更不能直接推导出实际 Token 生成速度会相差 3.36 倍。真实推理还会受到模型结构、量化方式、算子、缓存命中率、软件栈和并行策略影响。
更重要的是,显存容量不足和显存带宽不足,后果并不一样。
显存容量不足时,模型权重、KV Cache 或中间状态无法同时放进显存,任务可能直接无法启动,或者只能把部分数据放到系统内存,性能随之大幅下降。
显存带宽较低时,通常体现为数据吞吐减少。模型仍然可能运行,只是推理吞吐、并发能力或 Token 生成速度受到影响。
所以,“装得下”与“跑得快”是两项指标。RTX PRO 5500 优先解决前一项。
84GB 显存本身也可能限制了显存颗粒的频率。要做到 84GB,可能需要使用 24Gb、也就是单颗粒 3GB 容量的 GDDR7 颗粒。高容量颗粒不一定能达到最高速率,这可以解释为什么产品增加了显存,却没有同步获得更高带宽。
位宽争议也与此有关。PNY 写的是 416-bit,HotHardware 认为 448-bit 更可能,而官方页面没有列出位宽。这句话不出自英伟达,现阶段就不能替它下一个确定结论。
70B 模型、128K 上下文和 Agent 工作负载
“AI 需要大显存”太宽泛。更具体的情况是,模型权重只是显存开销的第一部分。
以 70B 参数模型为例,在 INT4 量化下,模型权重可能需要约 35GB 显存。若上下文长度达到 128K tokens,KV Cache 还可能额外占用 8GB 到 16GB。模型权重和 KV Cache 之外,系统还要保存多轮对话历史、工具调用记录、缓存以及推理过程中的中间状态。
这组数字不是所有 70B 模型、量化方案和推理框架的固定需求,但足以说明 32GB 显存为什么容易触及限制。
一次普通问答,模型读取输入并生成输出,显存使用相对容易控制。Agent 工作流则复杂得多。它可能依次完成以下动作:
- 接收用户指令并理解上下文;
- 调用搜索、数据库、文件系统或 API;
- 读取工具返回的内容;
- 保存中间结果,继续规划下一步;
- 汇总多个结果后生成最终输出。
每一次工具调用都可能增加上下文长度。多轮任务还会保留更多历史信息。如果同时运行多个 Agent,每个实例又可能拥有自己的上下文和缓存。
因此,84GB 的价值主要体现在几个地方:允许运行更大的模型,容纳更长的上下文,为 KV Cache 留出余量,并让多个任务在同一张卡上并行运行。它不保证更高的 Token 生成速度,但可以减少模型因显存不足而无法启动的情况。
Anthropic 的 Claude Computer Use、OpenAI 的 Operator,以及字节跳动的 Coze,都可以用来说明 Agent 工作流正在从一次性文本生成转向连续的工具调用和任务执行。这些项目并不意味着已经采用 RTX PRO 5500,也不能据此推断英伟达为某个具体产品做了定向适配。它们说明的是一种工作负载变化:模型需要保留更多上下文,也需要在更长时间内维持状态。
对多 Agent 或独立上下文并行场景来说,显存需求可能快速增加,甚至呈现近似指数级扩张的趋势。这是对特定工作流的分析,不是适用于所有 AI 应用的通用定律。
英伟达在 RTX PRO 5500 的产品介绍中,将 Agentic AI 排在物理模拟和图形渲染之前。这个顺序至少说明,产品定位已经超出传统的专业图形工作站,开始强调本地 AI 推理和大显存任务。
ECC、MIG 和 NVDEC,专业卡贵在哪里
RTX PRO 5500 的专业价值,不应只按“每 GB 显存多少钱”来计算。
它支持 ECC 纠错。游戏中的偶发显存位翻转,可能只表现为一次画面异常或程序崩溃;但在金融分析、医疗诊断、科学计算和长时间 AI 推理中,错误数据可能进入计算链路,影响最终结果。ECC 不能让系统绝对不出错,却能提高持续运行时的数据可靠性。
MIG 则解决资源隔离问题。现有信息称,RTX PRO 5500 最多支持 2 个 MIG 实例,可以把 84GB 显存切分成两个约 42GB 的逻辑 GPU,供不同团队、任务或租户使用。RTX PRO 6000 最多支持 4 个 MIG 实例,隔离能力更强。
这类功能对共享工作站或企业服务器有实际意义。一个团队运行推理任务时,不必完全独占整张卡;另一个任务也可以获得相对独立的显存和计算资源。不过,MIG 是否值得支付额外成本,取决于组织是否真的需要资源隔离。单用户本地工作站未必能从中获得同样收益。
视频处理也是差异之一。RTX PRO 5500 配备 3 个第六代 NVDEC 解码器,RTX 5090 配备 2 个。额外的解码能力可能帮助影视后期、虚拟制片和实时视频分析场景同时处理更多视频流,再把解码结果交给 AI 模型分析、转码或预览。
ECC、MIG、更多 NVDEC,以及面向专业应用的驱动和部署支持,共同构成专业卡的溢价。它们不是跑分表上的一个大数字,但在企业工作流中可能直接影响可用性和资源管理。
600W 功耗让它更像基础设施组件
RTX PRO 5500 的整卡功耗上限为 600W,与 RTX PRO 6000 相同。这个数字不等于性能一定更强,却直接决定了部署条件。
高负载运行需要专用供电接口、足够强的散热系统和能够持续排出热量的机箱或机架环境。RTX PRO 5500 提供主动式气冷和液冷方案,液冷版本使用 RXM 规格散热模块,适用于部分机架式部署场景。
视频资料提到它使用 12VHPWR 供电接口,并提醒高负荷环境下曾有相关故障记录。这里更适合把它看成采购和部署时需要检查的风险点,不能扩大成这张卡普遍存在质量问题。
600W 也意味着它未必适合普通个人电脑机箱。用户需要同时确认电源余量、供电线材、机箱空间、散热方式、主板兼容性和驱动环境。文章把它理解为面向持续高负载、甚至 7×24 小时运行的设计目标,但这属于产品定位判断,不是英伟达对运行时长的保证。
官方一个价都没给,价值要等报价落地
目前最关键的不确定因素仍然是价格。
已知的条件性信息包括:
- RTX 5090 的 1,999 美元价格未能在英伟达官方页面核实;
- HotHardware 报道 RTX PRO 5000 48GB 版本为 8,599 美元起;
- RTX PRO 5500 的价格只有媒体推测,大概率超过 10,000 美元;
- 如果以 10,000 美元作为假设,84GB 显存的平均价格约为每 GB 119.05 美元。
这些数字不能写成 RTX PRO 5500 的正式售价。官方一旦公布报价,按 10,000 美元计算的每 GB 价格也需要重新计算。
专业卡的价格更不会简单等于消费卡价格乘以显存容量。ECC、MIG、专业驱动、散热方案、供应情况、验证周期和企业服务都会改变最终价格。对只关心单卡推理速度的用户来说,这些功能未必值回差价;对需要长期运行、资源隔离和大模型本地部署的团队来说,显存容量可能直接决定项目能不能运行。
RTX PRO 5500 的价值,不在于它是否全面超过 RTX 5090。它要回答的是另一个问题:需要大显存跑推理,但不想为顶级算力多掏一倍钱的人,能不能用这张卡把更大的模型、更长的上下文或更多并行任务装进一张工作站 GPU。
就目前能确认的信息看,RTX PRO 5500 的产品逻辑已经比较清楚:它用较低的带宽换取 84GB 显存,并加入 ECC、MIG、更多 NVDEC 以及专业部署特性。显存这道闸门是真的,闸门上的价码,仍要等英伟达自己报价那天才能算清楚。