Kimi K3.1 Pro 发布后,哪些能力经得起实测?
Kimi K3.1 Pro 有 1M 上下文和两种速度档位,官方基准与第三方测试表现各异。编程成本、3D 结构正确性、API 计费和接入限制,都需要结合实际工作流评估。
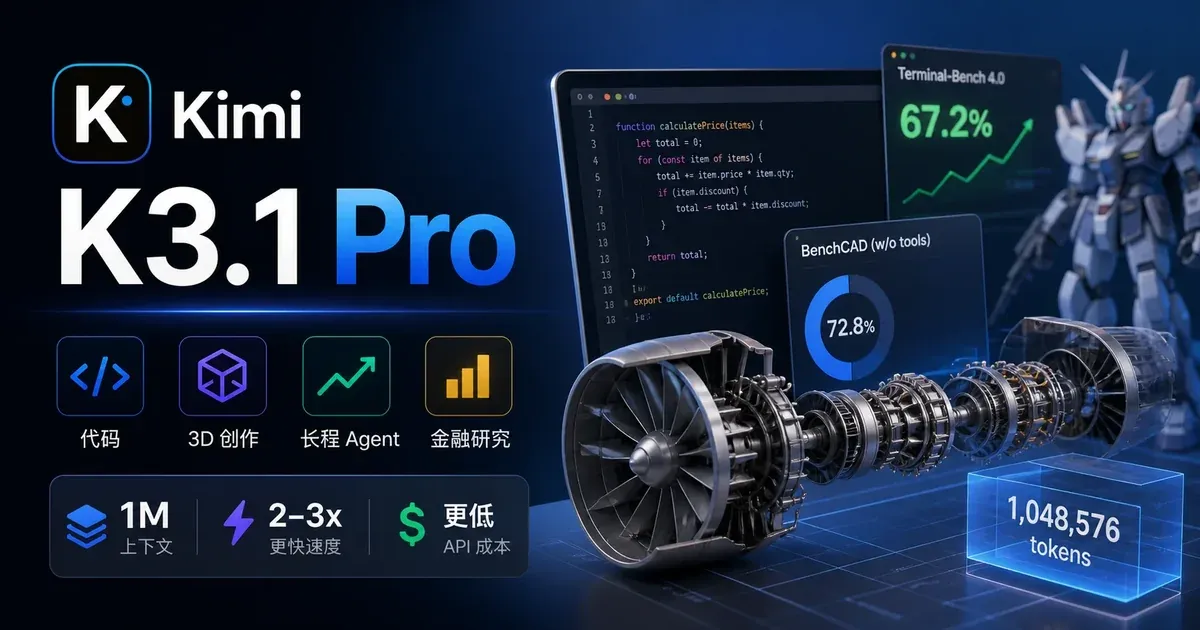
Kimi K3.1 Pro 于 2026 年 10 月 23 日发布。它被定位为面向代码、长程 Agent、3D 创作和金融研究的旗舰模型。发布资料里的基准成绩看起来有竞争力,独立测试则呈现出更具体、也更不整齐的图景:部分编程任务跑得更快、花费更低;3D 场景能做出交互,但几何和运动细节仍可能出错。
评估这类模型,首先要把几种证据分开看:厂商基准说明模型在特定规则下能做到什么,第三方榜单提供另一套测试结果,单个评测者的实测则更接近具体任务体验。它们可以互相补充,不能拼成一张统一排行榜。
一个旗舰型号,两种调用入口
官方 API 型号是 kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed;Kimi Code 使用的名称则是 k3.1-pro 和 k3.1-pro-highspeed。命名相近,不代表产品入口相同:Kimi Code 订阅与按量 API 的计费方式、限额和调用条件不同,订阅额度也不能直接折算成 API 余额。第三方供应商是否接入,还要看其实际目录和调用结果。
两个型号都支持 1,048,576 tokens,也就是常说的 1M 上下文。思考模式始终开启,推理强度可设为 low、high 或 max。官方称 Highspeed 版本智能水平相同,输出速度约为标准版的 2 到 3 倍。这是官方对产品的描述,不是本次材料中的独立速度测量。
推理强度的默认值存在文档差异。官方快速入门称默认是 max;Coding 文档的模型配置页写 high,概览页仍写 max。原生测试没有独立确认省略该参数时实际使用的档位。接入时最好显式指定推理强度,而不要靠一个未经核实的默认值。
参数规模也要留出余地。官方称 K3.1 Pro 为“三万亿级”模型;Artificial Analysis 披露的总参数为 2.8T、激活参数为 104B。两者属于不同精度层级的说法,不能把官方的量级描述改写成精确的 3T,也不宜把未公开的内部规格当作确定事实。
成绩不能拼成一张榜
官方发布资料给出的 Terminal-Bench 4.0 成绩为:K3.1 Pro 65.7%,GPT-6 Astra 58.2%,Claude Opus 5.5 66.4%。Artificial Analysis 的 Terminal-Bench 4.0 结果则是 67.2%。这两个 K3.1 Pro 数字来自不同评测口径,不应混在一起直接排序。
| 项目 | Kimi K3.1 Pro | 对照或说明 |
|---|---|---|
| 官方 Terminal-Bench 4.0 | 65.7% | GPT-6 Astra 58.2%;Claude Opus 5.5 66.4% |
| Artificial Analysis Terminal-Bench 4.0 | 67.2% | 与官方成绩口径不同 |
| Kimi Code Bench 3.0 Long-horizon | 61.2% | 前代 K3 为 55.95% |
| BenchCAD,有工具 | 92.7 | 官方资料所列成绩 |
| BenchCAD,无工具 | 72.8% | 核对资料所列成绩 |
| Office QA Pro v2、SpreadsheetBench 2 | 官方称取得最佳成绩 | 不能据此推断所有办公任务都可靠 |
BenchCAD 尤其需要注意工具条件。官方资料列出有工具成绩 92.7;核对资料另列出无工具成绩 72.8。作为参照,评测文章列出的 Claude Opus 5.5 为 96.2、GPT-6 Astra 为 95.9,但这些数字只有在测试条件一致时才适合比较。工具可用性会改变模型能完成的操作,也会影响分数含义。
Artificial Analysis 给 K3.1 Pro 的 Intelligence Index 为 55,发布时排名第 4;GDPval-AA 为 1,846 Elo。这是第三方成绩,适合用来了解它在该机构评测中的位置,不等于对每一类实际工作的预测。官方还称 K3.1 Pro 在 Frontier Finance 上较 K3 有提升,但这不意味着金融研究或交易流程已经可以整体交给模型自动完成。
TOKRACE 的原创 API 测试样本较小,也不构成综合排名。测试中,51 次请求里有 69 次首轮请求派发;30 道文本题和 4 道代码题的完整回答通过检查。测试还遇到截断、HTTP 429,以及未发送的任务。这些情况不能简单记作模型答错。测试使用 Kimi Coding 原生 Anthropic Messages 接口,消耗的是订阅额度,没有产生按量 API 的实际账单。
目前这组测试尚未覆盖复杂代码仓库、完整工具调用、百万 token 上下文和多模态工作流。它能提供局部线索,不能替代对自己任务的验收。
编程测试:省时省钱,不等于质量全面领先
一段编程基准视频中,评测者使用自己的测试脚本和案例比较 K3 与 K3.1 Pro。作者报告,K3 的每个提示词平均花费约 63 美分、耗时 12 分钟;K3.1 Pro 高档约为 20 美分、4 分钟,综合分数与 K3 接近。这是特定评测脚本下的结果,不是任何项目都能复现的价格或速度保证。
这段视频由 Moonshot 付费赞助。作者披露了赞助关系,并表示基准脚本和方法没有改变,也会展示脚本结果。看这些数字时,这一背景值得一并保留;它不自动推翻测试,但说明结果应按具体测试来理解。
同一作者在 Kimi Code 和 OpenCode 中测到的成绩不同,OpenCode 得分高出三分多。React/TypeScript 代码质量,以及修复和查找 Bug 的项目出现了改善。作者推测差异可能来自系统提示词或工具调用方式,但原因没有确认。换一个运行环境,结果就可能改变,因此不能把其中一个分数直接当作模型的固定水平。
最高推理档的一次 Bug Review 得分约为 9.17/10:测试者在代码中植入 16 个问题,模型找出 14 个,没有误报。这次调用花费 7.48 美元,耗时约半小时。它说明复杂审查任务可能耗时且昂贵,也只是单项测试,不代表常规调用的平均成本。
作者的总体判断是,K3.1 Pro 已接近前沿组,但还没有达到其认为最顶尖的水平。他也提醒,排行榜上相差一两分,可能来自统计噪声或测试误差,不能据此断言稳定的能力差距。
3D 生成:场景能跑起来,结构仍要检查
另一位视频作者用一组 3D 与交互任务做了个人实测。结果不适合概括成“擅长 3D”或“不会 3D”:模型完成了不少主要要求,但任务越依赖几何、运动和工程结构,越容易暴露问题。
Xbox 手柄任务中,模型做出了手柄形状、按键和基本交互,精细程度不如对照模型。四季星球和机械腕表也基本实现了提示词要求,差距主要落在细节和材质。高达任务包含较复杂的模式和动作,主要要求基本完成,但页面运行较卡,整体观感不佳。
问题更明显的任务包括:
- 鹈鹕骑车:SVG 车轮的轮毂被画成射线,链条没有运动。
- 火箭发射模拟:镜头跟随、部件分离等要求出现问题。
- 机械蜘蛛:关节运动不符合预期。
- 涡扇发动机和汽车发动机:几何形状、零件或结构存在错误。
这些失败不只是“画得不够精致”。发动机的部件关系、蜘蛛关节的运动方式和火箭分离过程都涉及结构正确性。模型生成一个可交互场景,并不能证明场景中的几何和动作符合物理或工程逻辑。
视频作者还观察到,3D 场景与 UI 组合后更容易出错。这是对这组测试的观察,尚未验证为普遍机制。该视频只覆盖作者在一天内完成的特定任务,不能代表所有 3D 软件、工作流或模型版本。
网页审美方面,作者认可 K3.1 Pro 的页面布局、文字排版和餐饮网页表现;但就整体审美而言,他认为效果仍逊于 Claude Opus 5.5 与 GPT-6 系列。这属于评测者的主观比较,适合作为体验记录,不是可直接量化的基准成绩。
API 价格:读、写、命中要分开算
下面列出官方 API 标价,单位均为每百万 tokens。国际和国内价格属于不同区域,不能与 Kimi Code 订阅价格混为一谈。
| 区域与型号 | 未缓存输入 | 输出 | 缓存命中输入 |
|---|---|---|---|
| 国际 Pro | $2 | $10 | $0.20 |
| 国际 Highspeed | $4 | $20 | $0.20 |
| 国内 Pro | ¥13 | ¥68 | ¥1.30 |
| 国内 Highspeed | ¥26 | ¥136 | ¥1.30 |
缓存写入是另一项费用。国际 Pro 的 5 分钟和 1 小时缓存写入分别为每百万 tokens $2、$4;Highspeed 分别为 $4、$8。国内 Pro 分别为 ¥13、¥26,Highspeed 分别为 ¥26、¥52。缓存写入、缓存命中读取和未缓存输入是不同计费项。同一段输入不能既按写入价又按命中读取价重复计算。
以国际 Pro 为例,假设一次请求有 100,000 个输入 tokens、10,000 个输出 tokens,且没有命中缓存:
- 输入:0.1 × $2 = $0.20
- 输出:0.01 × $10 = $0.10
- 合计:$0.30
若这 100,000 个输入 tokens 全部命中缓存,读取成本为 0.1 × $0.20,即 $0.02;输出仍为 $0.10,合计 $0.12。实际请求可能同时包含缓存命中和未命中部分,也可能另有缓存写入费用。这个例子不包括所有调用细节,只展示公开单价如何影响账单。
编程基准视频报告的每提示词 20 美分,是其脚本案例中的平均结果,不能直接拿来和上述 token 计算对照;提示词长度、输出长度、推理档位和缓存情况都会改变费用。最高档 Bug Review 的 7.48 美元则是单次复杂任务的账单,也不是一般调用的参考均价。
价格比较还要区分地区与产品。另一篇评测资料列出的 K3 国际 API 价格为输入 $3、输出 $15、缓存读取 $0.30;有视频作者则以国内标价 ¥13/¥68 评价价格偏高。不同版本、地区和产品入口并非同一套价格,比较前要先确认计费对象。
订阅体验也不能从个别反馈推导成普遍结论。社区中有人反映额度限制,视频作者也记录了相关抱怨;TOKRACE 的测试则触及的是 5 小时窗口频限并收到 HTTP 429,不等于月度额度耗尽。编程基准视频作者建议现阶段优先考虑按量 API 密钥,这是他基于自身测试和社区观察给出的建议,不适用于所有用量模式。
接入前先核对这些限制
官方 API 的 max_completion_tokens 默认值为 131,072,最大可设为 1,048,576,但实际可用长度还受剩余上下文空间限制。应用需要处理输出截断,不能假定模型总能在一次响应中完成长任务。
temperature=1.0、top_p=0.95、n=1、presence_penalty=0 和 frequency_penalty=0 是固定值,官方建议不要显式传入。若客户端沿用其他模型的参数设置,应检查是否与 K3.1 Pro 的接口要求冲突。
视觉输入不支持公网图片 URL。图片需要使用 base64 或 ms://<file-id>,消息内容则须为对象数组。多轮对话和工具调用时,必须原样回传完整的 assistant message,并按对应的 tool_call_id 回传工具结果。只保留文本内容、丢掉工具调用字段,可能让后续对话无法正确继续。
官方文档称联网搜索功能正在更新,近期不建议用于生产流程。第三方路由也要以实际目录和成功调用为准:Modelflare 在 2026 年 10 月 23 日 18:03 UTC 的公开目录查询中,没有列出 K3.1 Pro 或 Highspeed。仅仅把客户端模型名改成某个字符串,不能证明供应商已经支持路由或实际调用。
目前能下什么结论
K3.1 Pro 值得进入复杂编程、长程 Agent 和 3D 工作流的候选名单。现有编程测试显示,在特定脚本下速度和 API 成本有所改善,部分代码质量与 Bug 查找任务也有提升。3D 实测则表明,它能生成有交互的场景,但结构、运动和工程细节需要人工检查。
事实准确性也有专项压力测试成绩。官方快速入门报告,单项事实陈述错误率从 K3 的 23.35% 降至 6.85%;至少含一处事实错误的回答比例约为前代的 46.4%。官方同时说明,样本刻意聚焦容易出错的情形,不代表日常使用的总体水平。另一份发布资料的英文博客数字为 23.4% 降至 8.3%。两组数字存在来源差异,不应合并成一个结果。
网络安全成绩同样有条件:官方披露,在 xdev-bench-hard 上,未移除相关网络攻防数据时 pass@3 为 90.5%,最终版为 81.0%。这反映的是特定基准及其数据处理背景,不能脱离测试条件单独解释。
目前不宜据此断言 K3.1 Pro 全面领先所有模型,也不能推断它能可靠完成所有 3D 任务、官方基准可以代表真实项目,或订阅和 API 对所有用户都划算。更稳妥的做法,是拿自己的代码库、目标 3D 工具、金融数据和工具链做验收。比较最终可用结果的质量、耗时和总成本,并记录失败、截断和人工返工,而不是只看排行榜分数或生成速度。